13 家大模型 API 隐私尽调:至少 3 家默认拿数据改进服务,4 家没有公开 DPA
 Kaamel Lab
我们把 13 家大模型厂商面向海外客户的 API 条款放在一起核对:条款明确写了默认把客户数据用于训练或改进服务的,至少有 DeepSeek、Kimi、MiniMax 三家的 API,另有四家写得不清楚;这三家再加上百度千帆国际版,四家都没有公开的数据处理协议(DPA),公开条款里也找不到 GDPR 要求的处理者条款。OpenAI、Anthropic、Google 付费层、xAI、阿里云国际站和 BytePlus 默认不训练;六家欧美厂商默认把 prompt 和输出留 30 到 55 天做滥用监控,只有 Z.ai 书面写明默认不存储。对服务欧美用户的企业,接入一个大模型 API 通常就是新增一个数据处理者,GDPR 和 CCPA 都要求书面约定处理范围;数据如果涉及美国人,还要看美国司法部的数据安全规则。
核心要点
- 默认不训练的有六家:OpenAI、Anthropic、Google Gemini API 付费层、xAI、阿里云 Model Studio 国际站、BytePlus;条款明确写了默认用于训练或改进服务的有三家:DeepSeek、Kimi 国际版、MiniMax 国际版,其中只有 DeepSeek 明写”训练”,另两家写的是”开发和改进服务”;Mistral 按量付费、Cohere、Z.ai、百度千帆国际版写得不清楚。
- 13 家里只有 Z.ai 在数据处理协议里写明默认不存储 API 内容;OpenAI、Anthropic、Mistral、xAI、Cohere 默认留 30 天,Google Gemini Developer API 留 55 天;中国厂商的海外版大多只写”必要期限”或”账户存续期间”。
- 推理所在地和签约主体要分开看:DeepSeek 在中国境内处理与存储;百度千帆国际版部分个人信息存在中国;阿里云国际站的 International 推理范围写明不含中国大陆,Global 范围没有排除;MiniMax 国际版只披露存储在美国。
- 厂商留数据主要为了四件事:滥用监控、被标记内容的安全调查、法律义务、你主动使用的有状态功能。零留存(ZDR)只关掉第一类,Anthropic 被标记内容在零留存下同样最长留 2 年。
- DeepSeek、Kimi 国际版、MiniMax 国际版、百度千帆国际版没有公开 DPA,公开条款里也找不到处理者条款;Z.ai 的 DPA 缺子数据处理和审计条款,这五家在美国企业的合规审核里通常过不了第一关。
本文写给向欧美市场卖产品、正在选模型 API 的团队,是”AI 供应链的隐私合规”系列的第二篇。第一篇画出了一条 prompt 会落进的 10 类存储;本文只看模型厂商这一跳,网关、推理托管和 Agent 工具链留给后续几篇。第一部分是事实,第二部分讲合规团队拿这些事实怎么审供应商。中国厂商只看卖给海外客户的版本。条款以 2026 年 9 月 17 日的版本为准,这个领域的条款变得很快,签约前请按附录链接再核一次。
第一部分:13 家厂商的条款里写了什么?
接入大模型 API,法律上是在做什么?
通常是把个人数据交给一个数据处理者。用户数据经由 prompt 进入厂商的推理服务,厂商按你的指令处理并返回结果:在 GDPR 下这是数据控制者与数据处理者的关系,在 CCPA 下是企业与服务提供者的关系。两部法律都要求书面合同,写明处理目的与范围,禁止处理方超出约定使用数据,并把同样的约束传给下游;GDPR 还要求合同终止后删除或返还数据。
厂商一旦把数据用于自己决定的目的,比如训练自己的模型,这部分处理就不在上面的关系里了。在 GDPR 下,角色要看谁决定这部分处理的目的和方式:厂商自己决定的,通常是独立控制者,和你共同决定的则可能是共同控制者;无论哪种,你向它提供数据都需要自己的合法性基础。如果你的业务受 CCPA 约束,厂商超出服务提供者合同允许的用途使用数据,就很可能不再符合服务提供者的条件,这次提供可能被认定为”出售”或”共享”,消费者对此有权选择退出。
第一篇把这些要求压成了六个问题,本文沿用同一张表:
| # | 问题 | 涉及的法律 |
|---|---|---|
| 1 | prompt 和输出默认留多久?为了什么留? | GDPR、CCPA(加州消费者隐私法,美国企业客户最常用作基准的州法) |
| 2 | 零留存是否可得?覆盖哪些端点? | GDPR、CCPA |
| 3 | 默认是否用于训练?开关在哪,是选择加入还是选择退出? | GDPR、CCPA、FTC 法(禁止不公平或欺骗性商业行为) |
| 4 | 推理和存储物理上在哪?能否选区域? | GDPR、美国司法部依 EO 14117 制定的数据安全规则 |
| 5 | 谁能人工查看?看多久? | GDPR、CCPA |
| 6 | 签约主体是谁?有无公开 DPA 和子数据处理者清单? | GDPR、CCPA |
13 家的隐私开关:训不训练、能不能零留存、推理跑在哪?
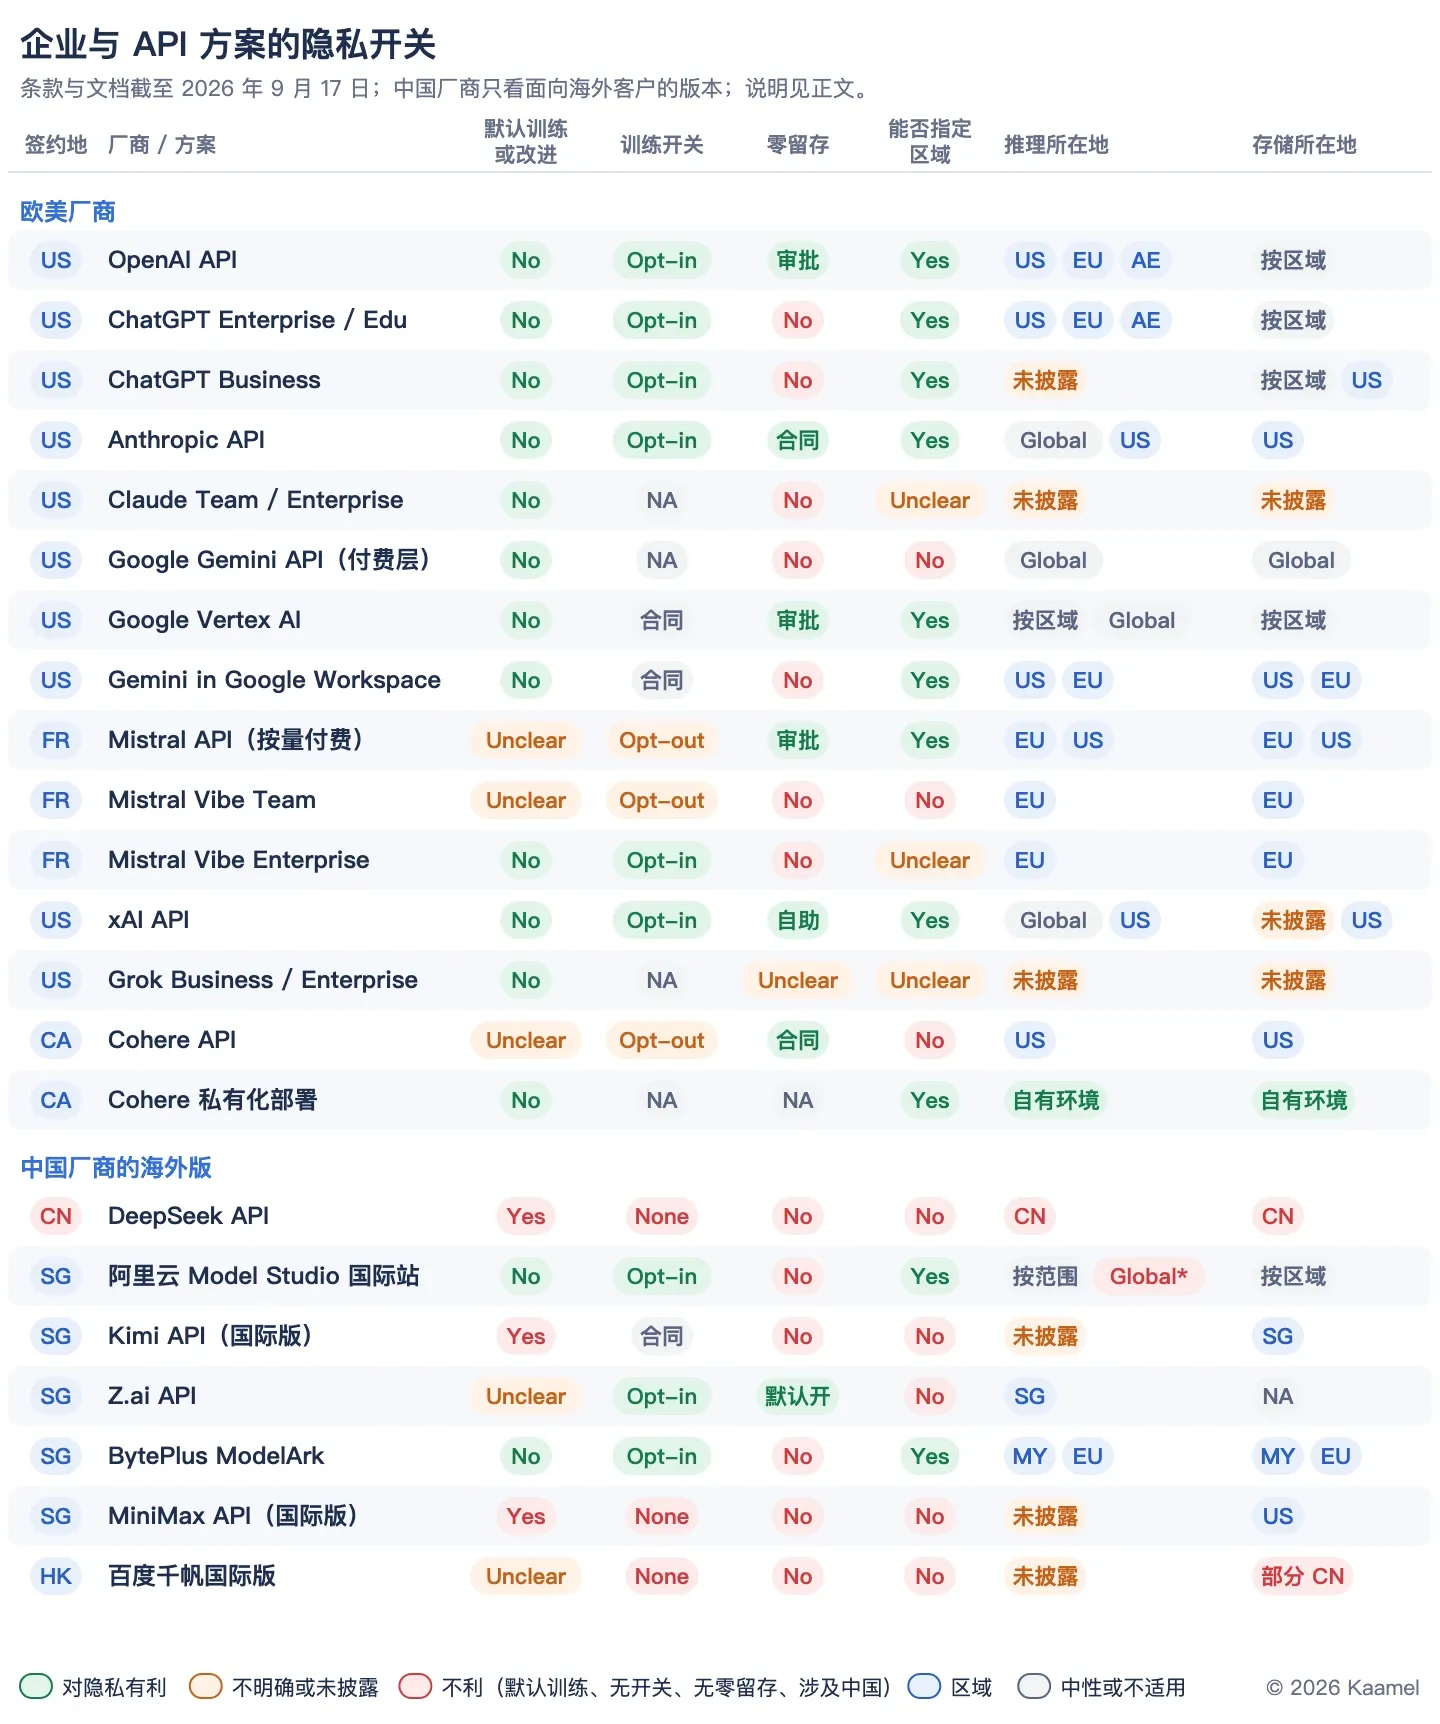
同一家厂商的个人版、企业版和 API 往往适用不同条款,所以图按方案分行,只有处理方式不同才拆开。企业与 API 方案里,条款明确写了默认用于训练或改进服务的是 DeepSeek、Kimi、MiniMax 三家的 API,另有四家写得不清楚。个人版和免费层正好反过来,大多默认训练,也没有一项提供零留存。
企业与 API 方案
图中取值:Yes / No 是条款写明的,Unclear 是没写或文件互相矛盾,None 是找不到开关,NA 是不适用。零留存一栏写开通方式(默认开、自助、审批、合同),No 是没有。Global 表示不承诺区域;Global* 是阿里云的 Global 推理范围,没有排除中国大陆。
- OpenAI:零留存要审批,12 个端点可用;美国以外的区域都要先获批零留存或 Modified Abuse Monitoring。ChatGPT Business 选的区域只管存储,每条 prompt 在美国另存一份。
- Anthropic:Claude Team / Enterprise 的界面不支持零留存,例外是开了零留存的 Enterprise 组织里的 Claude Code;API 的
inference_geo目前只能限定美国。 - Google:Gemini Developer API 没有零留存,也没有区域选项。9 月更新后的文档直接让需要零留存的客户改用 Vertex AI。
- Mistral 与 Cohere:Mistral 只写按量付费客户”有权退出”训练,Cohere 提供退出开关,两家都没写默认状态,所以记 Unclear。
- Kimi API:条款允许用客户内容改进服务,帮助中心却写不训练,按有约束力的条款记 Yes。
- Z.ai:DPA 写明 API 内容不存储;使用条款里”不用于改进服务”那句在发布文本里带着方括号,训练记 Unclear。
- BytePlus:区域是柔佛和都柏林,文档写明欧盟流量可能溢出到亚太。
签约主体在新加坡,不等于数据不进中国。 DeepSeek 没有海外主体,接它的 API 就是和杭州的公司签约、数据在中国境内处理。意大利数据保护机构 Garante 2025 年 1 月以数据”保存于中华人民共和国”为由限制其处理;韩国个人信息保护委员会 2025 年 4 月认定其未经同意把用户输入传到了北京火山引擎。这两项行动针对的是 DeepSeek 自己的 App;API 这边的依据是 DeepSeek 的隐私政策和开放平台条款,同样写明在中国境内收集、处理和存储个人数据。阿里云国际站把区域和推理范围分成两个设置,International 范围写明不含中国大陆,Global 范围在全球动态调度、没有排除中国大陆。
美国人的数据还要看所有权。 美国司法部依 EO 14117 制定的数据安全规则不只看数据在哪个国家,还看对方是不是”受涵盖人员”:在受关注国家注册或主营,或者被这类主体控股五成以上的公司都算。由中国公司控股的新加坡子公司同样可能落入范围。把达到批量门槛的美国人敏感数据交给这类主体做推理,可能构成受限交易,要满足美国网络安全和基础设施安全局(CISA)的安全要求。自查可以用 EO 14117 自测。
Anthropic 的 Covered Models 要求强制留存。 按 Anthropic 的 Covered Models 页面,Claude Fable 5、Fable 5.1、Mythos 5、Mythos 5.1 在 API、Bedrock、Google Cloud、Foundry 上都要求至少 30 天留存,用于安全工作;按 API 与数据留存文档,组织的留存配置不满足时,请求直接返回 400 错误。Anthropic 给符合条件的客户开了一个限时过渡,内部业务应用可以带零留存调用 Fable 5 和 5.1。采购这几个模型之前,先确认自己的零留存协议有没有为此留口子。
个人版与免费层
这些方案不该出现在生产链路里,列出来是为了评估员工用个人账号的风险。13 项都不提供零留存,所以图里只留四个维度。
ChatGPT 个人版和 Gemini App 默认训练,可以在设置里关;Claude 与 Grok 个人版有开关,官方没写默认状态;Gemini API 免费层不付费就关不掉。Qwen Chat 国际版写明在新加坡和中国大陆处理数据。Kimi App 的隐私政策页面显示的主体是北京月之暗面、存储在中国,这个页面可能按访问地显示不同版本,所以签约地记 Unclear。
厂商留存数据,通常是为了什么?
主要是四件事,而零留存和合同谈判只能动其中一部分。
| 留存目的 | 常见期限 | 零留存能否关掉 |
|---|---|---|
| 滥用监控 | 30 到 55 天 | 能 |
| 被标记内容的安全调查 | 数月到数年 | 不能 |
| 法律义务与诉讼保全 | 不定 | 不能 |
| 有状态功能 | 按功能,常为”直到删除” | 多数直接不可用 |
- 滥用监控:OpenAI 写”最长 30 天,除非法律要求更长”;Google 留 55 天,目的还包括”法律或监管披露”;xAI 留 30 天”用于在疑似滥用时审计”。
- 被标记内容:Anthropic 被标记的输入输出最长留 2 年、分类分数最长 7 年,前者明确写”即使有零留存或 HIPAA 安排”;BytePlus 过滤命中的内容在马来西亚留 180 天;OpenAI 被儿童性虐待材料(CSAM)扫描标记的图片在零留存下也保留供人工审查。
- 法律义务:各家都写”依法律要求可延长”,没有一家给上限。
- 有状态功能:OpenAI 的 Conversations、Assistants 和向量库留到你删除;Mistral 的 Agents API 留到你注销账户;Gemini Interactions API 默认
store=true,付费层 55 天;Anthropic 的 Batch 结果留 29 天、代码执行容器 30 天。
清单外还有两类。一是计费和用量元数据,零留存下照留。二是”改进服务”:Kimi 国际版、MiniMax 国际版和 DeepSeek 把它写成默认用途,百度千帆国际版写的是”研究和统计分析”。这一类是商业用途,不是安全需要,谈判时应该要求删除。
推理侧的缓存另有一条短时钟:OpenAI 的内存缓存 5 到 10 分钟不活跃就失效、最长 1 小时,另有 24 小时档;Anthropic 是 5 分钟或 1 小时;DeepSeek 的磁盘缓存默认开启,几个小时到几天清空。
法律保全会覆盖厂商的删除承诺。2025 年 5 月,纽约南区联邦法院在《纽约时报》诉 OpenAI 案中命令 OpenAI 保全所有原本会被删除的输出日志,按 2025 年 10 月 9 日的合意令,这项义务自 2025 年 9 月 26 日起终止,已保全的数据继续保留。ChatGPT Enterprise 后来被排除在保全范围之外;“零留存端点的 API 客户不受影响”是 OpenAI 自己的说明,法院命令里没有这句话。道理很简单:删除政策会让位于诉讼保全,从未存储的数据则无可保全。
有没有按行业给不同的留存方案?
有,但多数只是同一套留存条款加一份合同,真正改变数据怎么留的是 Anthropic、OpenAI 和 Google Vertex。
医疗(HIPAA)
- Anthropic 改变了留存方式:控制台可以自助开启 HIPAA 就绪,签标准业务伙伴协议(BAA),也可以找销售签定制版;开启后对整个组织永久生效,Batch、Files、代码执行这类不在范围内的功能直接返回 400。官方定位是零留存之外的另一条路:数据可以留,但加保护措施。
- OpenAI 叠加在留存档位上:业务伙伴与医疗附录覆盖指定端点,在 Eyes Off 或 Safety Retention 档位下,即使数据有留存也可以处理健康信息。
- 只加一份合同:Google 只能走 Vertex 的 Google Cloud BAA,Gemini Developer API 不在覆盖产品清单里;Mistral 为符合条件的服务提供 BAA;xAI 填 BAA 问卷后人工审核;Cohere 的 BAA 只覆盖定制模型项目,不含其 SaaS API。
- 明文禁止:Kimi 国际版、Z.ai、MiniMax 国际版禁止传入受 HIPAA 保护的健康信息;Z.ai 对美国用途还禁止传入 GLBA(美国金融隐私法)覆盖的非公开个人信息和违反 COPPA(美国儿童隐私法)的儿童数据。
政府与公共部门:Anthropic 的 Claude for Government 达到 FedRAMP High,Google Vertex 通过 Assured Workloads 提供 FedRAMP High 与 IL4。这是合规边界,留存条款不变。
受监管企业的中间档:OpenAI 的 Modified Abuse Monitoring 让 prompt 不进滥用日志,同时保留有状态功能;Eyes Off 保留日志但排除人工审查;Safety Retention 对”严重风险活动”留存并审查。Google Vertex 对签了 Google Cloud 主协议的客户默认免于提示日志。
不让厂商接触数据:Cohere 的私有化、VPC 与第三方云部署下”Cohere 不接收任何客户输入”;Mistral 提供本地部署和面向公共部门的主权算力。这是部署模式,不是留存条款。
如果你的数据受 HIPAA 覆盖,候选名单先去掉明文禁止健康信息的三家,再区分”签 BAA 即可”和”要换处理配置”两种;后者会让部分功能不可用,架构要按可用端点提前设计。教育和金融行业,13 家都没有公开的专门留存方案,靠通用的企业协议。
第二部分:这些事实对供应商审核意味着什么?
第一部分的事实,在供应商审核里各自对应一个动作:
- 默认用于训练或改进服务,且没有开关(DeepSeek、Kimi 国际版、MiniMax 国际版的 API):厂商对这部分处理是独立控制者,CCPA 下很可能也不算服务提供者。处理个人数据的场景,这几家在第一轮就该出局,除非能签下改变默认的企业协议。
- 零留存:合同要按端点附上功能资格表,写清哪些端点、模型和功能在范围内。被标记内容和法律保全照留,要写进风险评估。
- 推理在中国或未披露(DeepSeek、阿里云 Global 范围、Kimi、MiniMax、百度千帆国际版):跨境传输影响评估没法完成,要么请厂商书面确认推理位置,要么按最坏情况评估;涉及美国人数据的,再按 EO 14117 核控股关系。
- 留存目的:滥用监控的天数和零留存可以谈;被标记内容和法律保全谈不掉,但可以要上限和通知;“改进服务”应当删除。
- 行业方案:医疗场景先去掉明文禁止健康信息的三家,再区分签 BAA 和换处理配置。
他们能给你什么合规文件?
条款写得再好,拿不到文件也过不了采购。美国企业的安全团队通常先要这几样:DPA、子数据处理者清单、SOC 2(美国服务组织审计报告)与 ISO 认证,以及 AI Act 要求的模型文件。
图中取值:异议终止权指对新增子数据处理者谈不拢时能否终止服务;不完整是清单缺这项服务本身的条目;平台级是认证只覆盖云平台、没写到模型服务;非模板是训练数据说明不按欧盟模板;简版是 DPA 缺子数据处理、审计和泄露通知条款。
- OpenAI 的子数据处理者清单里有菲律宾的内容审核外包,被标记内容的样本会共享给它们。
- Anthropic 的模型文档、训练数据摘要和 ISO 42001 证书都公开;Mistral 的 AI Act 材料最全,41 个模型的训练摘要和下游技术文档都不设门槛。
- Google 的 ISO 42001 范围里有 Gemini Enterprise Agent Platform,没有 Gemini API;BytePlus 的 16 项认证没有一项写到 ModelArk。
- xAI 的信任中心只有一张申请表,签 NDA 才能看;Cohere 是唯一连 DPA 都要 NDA 的。
- 阿里云国际站的 DPA 允许拒绝竞争对手查看审计报告,只给”摘要副本”。
- BytePlus 的 DPA 在中国厂商海外版里最完整,带欧盟标准合同条款(SCC)和英国、瑞士、巴西、沙特附录;但子数据处理者清单里没有 ModelArk,异议救济只是”尽合理努力调整服务”。
哪些给不出来会卡住采购? 按美国企业通常的审核门槛,缺口分三档:
- 过不了合规审核:没有 DPA 或同等的处理者条款,或者没有子数据处理者清单。GDPR 要求控制者与处理者之间有包含法定条款的书面合同,CCPA 要求服务提供者合同写明特定限制;文件叫不叫 DPA 不重要,但标准条款里没有这些内容,就缺了法律要求的合同条款。没有子数据处理者清单,GDPR 本身并不禁止,但你没法核实自己授权了谁,也很难对变更提出异议,多数美国企业的采购标准会把它列为缺口。DeepSeek、Kimi 国际版、MiniMax 国际版、百度千帆国际版属于这一档;Z.ai 的 DPA 缺子数据处理、审计和泄露通知条款,对照 GDPR 的必备条款也过不了。
- 过不了安全审核:没有 SOC 2 报告。签 NDA 才给的算能给。DeepSeek、Kimi 国际版、Z.ai 明确没有,MiniMax 国际版和百度千帆国际版没找到。
- 要记录但不致命:ISO 42001 还不是硬门槛,但要记下认证范围,别把平台级认证当成模型服务的;如果你在欧盟部署,厂商没有 AI Act 训练内容摘要,你的文档要自己补;报告要 NDA 或申请,只影响流程时间。
另外三点值得记下。
ISO 42001 要看范围。 公司层面有这张证书的是 OpenAI、Anthropic、Google、Cohere,但 Google 的范围不含 Gemini API,中国厂商的海外版一家都没有。开源权重托管方 Fireworks AI 和 GitHub Copilot 也拿到了 42001,这张证书并不难拿;反倒是受 AI Act 约束最直接的 Mistral 没有。尽调记录要写认证范围,不能只写”有”。
子数据处理者的异议期从 10 天到 90 天。 Google 90 天且可终止;OpenAI 30 天;Anthropic 15 天;xAI 15 天且可终止;BytePlus 15 天加 15 天,只承诺尽合理努力;Mistral 10 天;阿里云国际站 10 个工作日,可终止该服务;Cohere 公开清单但不公开异议期。
同一家的文件经常对不上。 Z.ai 的”不用于改进服务”带着方括号发布,像没清理的草稿标记。BytePlus 2022 年的服务条款还保留”永久、不可撤销”的数据许可,新客户协议把它限定为技术数据;它的数据处理页列了印尼,区域页只有柔佛和都柏林。xAI 企业条款要求个人数据只走零留存端点,开发者文档却写”对大多数客户,我们不建议开启零留存”。尽调记录要写明依据的是哪份文件、哪个日期、哪个套餐。
他们已经填好哪些问卷?
很少,而且四份主流问卷里有两份根本不问 AI。
CSA CAIQ 与 AI-CAIQ。 云安全联盟(CSA)2026 年 6 月发布了 AI 控制矩阵 1.1 版,247 个控制目标,配套问卷 AI-CAIQ 把大模型 API 厂商归为”模型提供方”。截至 2026 年 9 月,CSA STAR 注册表共有 2737 条记录,按厂商法律实体名逐一检索,13 家没有一家提交过 AI-CAIQ。OpenAI 有一份 2024 年 4 月的 CAIQ,xAI 有一份 2026 年 1 月的 CAIQ v4.0.3;Anthropic 在注册表上只有 ISO 42001,按 CSA 的定义,STAR for AI 二级要”ISO 42001 加通过验证的 AI-CAIQ”,它不满足。阿里巴巴、字节跳动(以 Beijing Volcano Engine Technology 入表)、百度有记录,都不是 STAR for AI;Mistral、Cohere、DeepSeek、Moonshot、MiniMax、智谱没有记录。按品牌名搜会漏掉字节和阿里,要按法律实体名搜。
HECVAT。 美国高校采购几乎必填的安全问卷,当前版本 4.1.6,有 31 道 AI 题、8 道隐私题。EDUCAUSE 2025 年 7 月关闭了公开索引,说明”不收集已完成的 HECVAT”,现在只能逐家问。Anthropic 信任中心列了 HECVAT v4.1.6;OpenAI 列的是”HECVAT Full”和”HECVAT Lite”,这是第 3 版的命名,第 4 版已经合并为一份。
SIG。 美国金融和大型企业做第三方风险评估的常用问卷,企业版许可每年 7,000 美元。Anthropic 信任中心列了 SIG Lite 和 CAIQ Full,注意这份 CAIQ 在信任中心申请获取,没有提交到 CSA 注册表。
VSA。 Vendor Security Alliance 的两份问卷免费,但”当前版本”最后更新于 2022 年 2 月,全文搜不到 AI、machine learning、LLM、generative 任何一个词。
结论是 AI 专项问卷几乎没人预先填好,要拿答案得自己发题。
哪些能谈、哪些谈不动?
对照 GDPR 对数据处理协议的必备条款,13 家的缺口集中在四处。
区域与跨境传输。 可以在配置层面锁定区域的:OpenAI(美国以外区域要先获批零留存或 Modified Abuse Monitoring)、Mistral 的区域端点、阿里云国际站有地理边界的推理范围、xAI 的美国端点(仅 grok-4.6)、Anthropic 的 inference_geo(仅美国)。Google Developer API 和 Cohere 没有可选区域。BytePlus 有都柏林区域,但写明欧盟请求可能溢出到亚太。隐私政策对欧盟用户承诺了数据不出境的,要按端点逐个核,不能按厂商核。
人工访问。 六家欧美厂商都保留人工审查路径。OpenAI 把被标记内容的样本共享给子数据处理者,Eyes Off 档可以排除人工审查;Anthropic 写明默认没有员工能读取 Covered Models 留存的对话,每次访问记入防篡改日志。中国厂商的海外版普遍保留自动内容检测。
子数据处理者。 公开清单并给出异议期的有 OpenAI、Anthropic、Mistral、xAI、阿里云国际站、BytePlus;Google 有条款但没有 Gemini 专属清单;Cohere 公开清单、不公开异议期;其余五家没有清单。
终止后删除。 Mistral、Anthropic 承诺 30 天,BytePlus 180 天,OpenAI 和 Google 不给天数。13 家都没有披露备份的清除周期。
签约前至少要谈这五条:
- 按端点写明留存与零留存资格,把功能资格表作为合同附件,不要只引用一个随时会改的网页。
- 被标记内容的留存上限:写明最长多久、谁能看、是否通知你。
- 推理位置和存储区域分开约定:只约定存储区域挡不住推理跨区;“全球""国际”这类范围要厂商列出国家。
- 子数据处理者清单作为附件,约定异议期和救济;没有清单的厂商,这一条要从头起草。
- 终止后删除的天数、备份清除周期和诉讼保全通知:可以参考 xAI 在零留存下”客户自行负责保存副本”的写法,把责任边界写清楚。
有些条款基本谈不动:Google Developer API 的 Search / Maps grounding 日志留 30 天且无法关闭(Vertex 上是 3 天);Cohere 不签 NDA 就看不到 DPA;Kimi 国际版、MiniMax 国际版、百度千帆国际版、DeepSeek 没有公开 DPA,谈判要从零开始。Anthropic Covered Models 的 30 天留存原本是准入条件,已经出现过渡期零留存,续约时值得再问。
你该问什么:十条要害问题
从 HECVAT 4.1.6 和 AI-CAIQ 里选出十条,题号按 EDUCAUSE 官方文件,星号是 HECVAT 标为关键的题。
- 敏感数据进入你方 AI 模型后,能否应请求从模型中移除?(AISC-01*)“删除对话”和”从模型中删除”是两回事。
- 用户输入数据是否用于影响你方 AI 模型?(AISC-02*,含微调、训练、个性化)决定厂商是处理者还是独立控制者。
- AI 处理过程中是否留存机构数据?(DPAI-02*)要问到天数、目的和按功能的差异。
- 机构数据是否经由也使用 AI 的第三方或子数据处理者处理?(DPAI-04)聚合网关和云托管场景尤其要问。
- 你与子数据处理者之间是否有关于数据保护与 AI 使用的协议?(DPAI-03*)GDPR 要求把义务传给下游。
- AI 功能能否按租户或按用户关闭?(AIGN-02*)员工场景和目的限制都靠它。
- 是否有含用户、时间、动作的不可篡改日志,并支持审计访问?(AISC-03*)审计权要靠日志落地。
- 训练数据与业务数据是否分离?客户能否退出模型改进?(AIML-01*)分离是”不训练”承诺的技术前提。
- LLM 功能或插件执行动作前是否需要人工确认?(AILM-03*)Agent 和工具调用场景的关键控制。
- 机构数据是否经共享 AI 服务处理?(DPAI-06)多租户是缓存隔离、滥用审查和子数据处理者问题的共同来源。
第 6 和第 9 题表面上问厂商,实际问的是你自己:把大模型 API 包进产品卖给客户后,HECVAT 的答题方就是你,能不能答”是”取决于你选的厂商和网关有没有提供这个开关。
合规团队接下来要做什么?
第一,把每个在用的大模型 API 登记进处理活动记录,至少记录签约主体、推理所在地、存储所在地、留存天数与目的、训练默认、零留存状态。中国厂商的海外版要单独核推理所在地,只写”全球""国际”的按未披露处理;涉及美国人的敏感数据,再核一遍控股关系。
第二,更新隐私政策里的数据处理者清单和跨境传输章节。对欧盟用户,Cohere 只能写”在美国处理”,Google Developer API 只能写”可能在 Google 设施所在的任何国家处理”,DeepSeek 要写”在中国处理”。跨境传输影响评估可以参考 CNIL 的六步 TIA 框架。
第三,做数据保护影响评估(DPIA)。EDPB 第 28/2024 号意见要求部署方评估模型是否由合法处理的个人数据开发。法国数据保护机构 CNIL 的说法更直接:使用外部 API 时”系统的控制几乎完全在供应商手里”,必须通过数据处理协议约束。
第四,把个人账号清出生产链路。ChatGPT 和 Gemini 的个人版默认训练,Claude 个人版有开关但官方没写默认状态,这几家的 API 和企业版默认不训练。员工用个人账号处理业务数据,就是把公司数据放进了训练默认开启的一侧,风险和自主智能体那篇讲的一样。
最后,把条款复核排进周期性工作。仅 2026 年,这 13 家就改了十几处:Gemini API 零留存页面和 xAI 安全 FAQ 都在 9 月中旬更新,xAI 的法律页面署名改成了 SpaceXAI LLC,BytePlus 的新客户协议 9 月 30 日生效。签约时看过一次不够,条款复核应该和密钥轮换放在同一张周期清单上。
常见问题
大模型 API 默认会用我的数据训练吗?
看厂商和套餐。OpenAI、Anthropic、Google 付费层、xAI、阿里云国际站、BytePlus 的 API 默认不训练;DeepSeek、Kimi 国际版、MiniMax 国际版默认把输入输出用于训练或改进服务;Mistral 按量付费和 Cohere 给了退出开关但没写默认状态,要在管理后台确认。几乎所有厂商的个人版和免费层都默认训练,所以生产链路里不能出现个人账号。
零留存是不是意味着厂商什么都不存?
不是。零留存通常只关掉滥用监控日志,覆盖哪些端点和模型要看功能资格表。被标记内容(Anthropic 最长 2 年)、计费元数据、你主动使用的有状态功能照样留存;OpenAI 被 CSAM 扫描标记的图片在零留存下也保留。Gemini Developer API 本身没有零留存,要改用 Vertex。
用中国厂商的海外版,数据就不进中国了吗?
不一定,签约主体在新加坡只说明合同在哪签。DeepSeek 在中国境内处理和存储;百度千帆国际版承认部分个人信息存在中国;阿里云国际站的 Global 推理范围没有排除中国大陆,要选 International 或美国这类有边界的范围;MiniMax 国际版和 Kimi API 只披露了存储地,没写推理在哪。服务美国用户时还要看控股关系,由中国公司控股的海外子公司可能被认定为 EO 14117 规则下的受涵盖人员。
要处理美国医疗数据,哪些厂商能签 HIPAA 业务伙伴协议?
OpenAI、Anthropic、Mistral、xAI 可以签;Google 只能通过 Vertex 签,Gemini Developer API 不在覆盖清单里;Cohere 的 BAA 只覆盖定制模型项目。Kimi 国际版、Z.ai、MiniMax 国际版明文禁止传入受 HIPAA 保护的健康信息,DeepSeek 写明服务不用于处理健康等敏感数据。
员工用个人 ChatGPT 或 Claude 账号处理客户数据,合规上算什么?
算把客户的个人信息交给了一个没有数据处理协议的第三方。消费者条款不是 GDPR 要求的数据处理协议,也不满足 CCPA 对服务提供者合同的要求,厂商按自己的隐私政策处理这些数据,你没有指令、删除或审计的权利。处理办法是两件事:把业务流量迁到 API 或企业版账号,并给员工一份写明允许和禁止用法的 AI 使用规范。
附录:来源
欧美厂商:OpenAI 数据控制、prompt 缓存、DPA v.010126、子数据处理者清单、关于 NYT 案的说明、信任门户、企业数据说明、企业隐私、ChatGPT 数据驻留、ChatGPT Business 数据驻留、ChatGPT 数据控制;Anthropic API 与数据留存、数据驻留、Covered Models、Covered Models 留存说明、商业客户数据留存、商业产品不训练说明、开发合作伙伴计划、Claude for Government、零留存范围、Enterprise 自定义留存、个人版训练与留存、DPA、信任中心与子数据处理者;Google Gemini API 条款、使用政策、零留存、Interactions API、数据处理者条款、子数据处理者、ISO 42001 范围、HIPAA 覆盖产品、Vertex 滥用监控、Vertex 零留存、Gemini for Government 部署、Vertex 数据驻留、Gemini App 隐私中心、Workspace 生成式 AI 隐私中心、Workspace 数据区域覆盖范围;Mistral 隐私政策、DPA、零留存说明、训练与退出、隐私开关、数据托管位置、区域推理、子数据处理者、信任中心文档、AI 治理模型清单;xAI 企业服务条款、企业 FAQ、消费者 FAQ、Grok Business 发布说明、DPA、安全 FAQ、区域端点、子数据处理者、信任中心;Cohere 企业数据承诺、数据使用政策、隐私政策、信任中心、子数据处理者、定制模型 BAA。
中国厂商的海外版:DeepSeek 隐私政策(英文)、App 使用条款、开放平台服务条款、上下文缓存;阿里云 Model Studio 国际站 区域与推理范围、隐私说明、产品条款、DPA、会员协议、推理范围说明;Qwen Chat 隐私政策;Kimi 国际版 服务条款、隐私政策、API 数据安全说明、Kimi App 隐私政策;Z.ai 隐私政策(含 DPA)、使用条款、Z.ai Chat 隐私政策、Z.ai Chat 服务条款;BytePlus ModelArk 数据处理说明、区域、内容预过滤、服务专用条款、客户协议、DPA、子数据处理者、合规认证、数据授权协议;MiniMax 国际版 隐私政策、服务条款、MiniMax Agent 隐私政策、MiniMax Agent 服务条款;百度千帆国际版 用户协议、隐私政策。
法规与监管:GDPR 全文(EUR-Lex);加州《消费者隐私法》(CCPA)法条;加州隐私保护局(CPPA)实施规章;EDPB 第 28/2024 号意见;CNIL 生成式 AI 问答;美国司法部数据安全项目;Garante 第 33/2025 号决定;韩国 PIPC 2025-04-24 通报;NYT 诉 OpenAI 案(多地区诉讼 1:25-md-03143):2025-05-13 保全令、2025-10-09 终止合意令。
合规文件与问卷:CSA AI 控制矩阵 v1.1 与 AI-CAIQ、STAR for AI 等级定义、STAR 注册表;EDUCAUSE HECVAT 4.1.6;Shared Assessments SIG;VSA 问卷;Mistral 合规中心;字节 Seed 透明度页;阿里云 Qwen 与 Wan 训练数据披露;Fireworks 信任中心、GitHub Copilot 信任中心;欧盟委员会训练内容摘要模板。
本文是工程与合规视角的条款阅读,不构成法律意见。相关阅读:AI 数据链路合规地图、Meta 被罚 12 亿欧元:SCC 为何不再够用、希腊数据保护局要求 DeepSeek 指定欧盟代表、韩国 PIPC 叫停 DeepSeek 新下载。
相关阅读
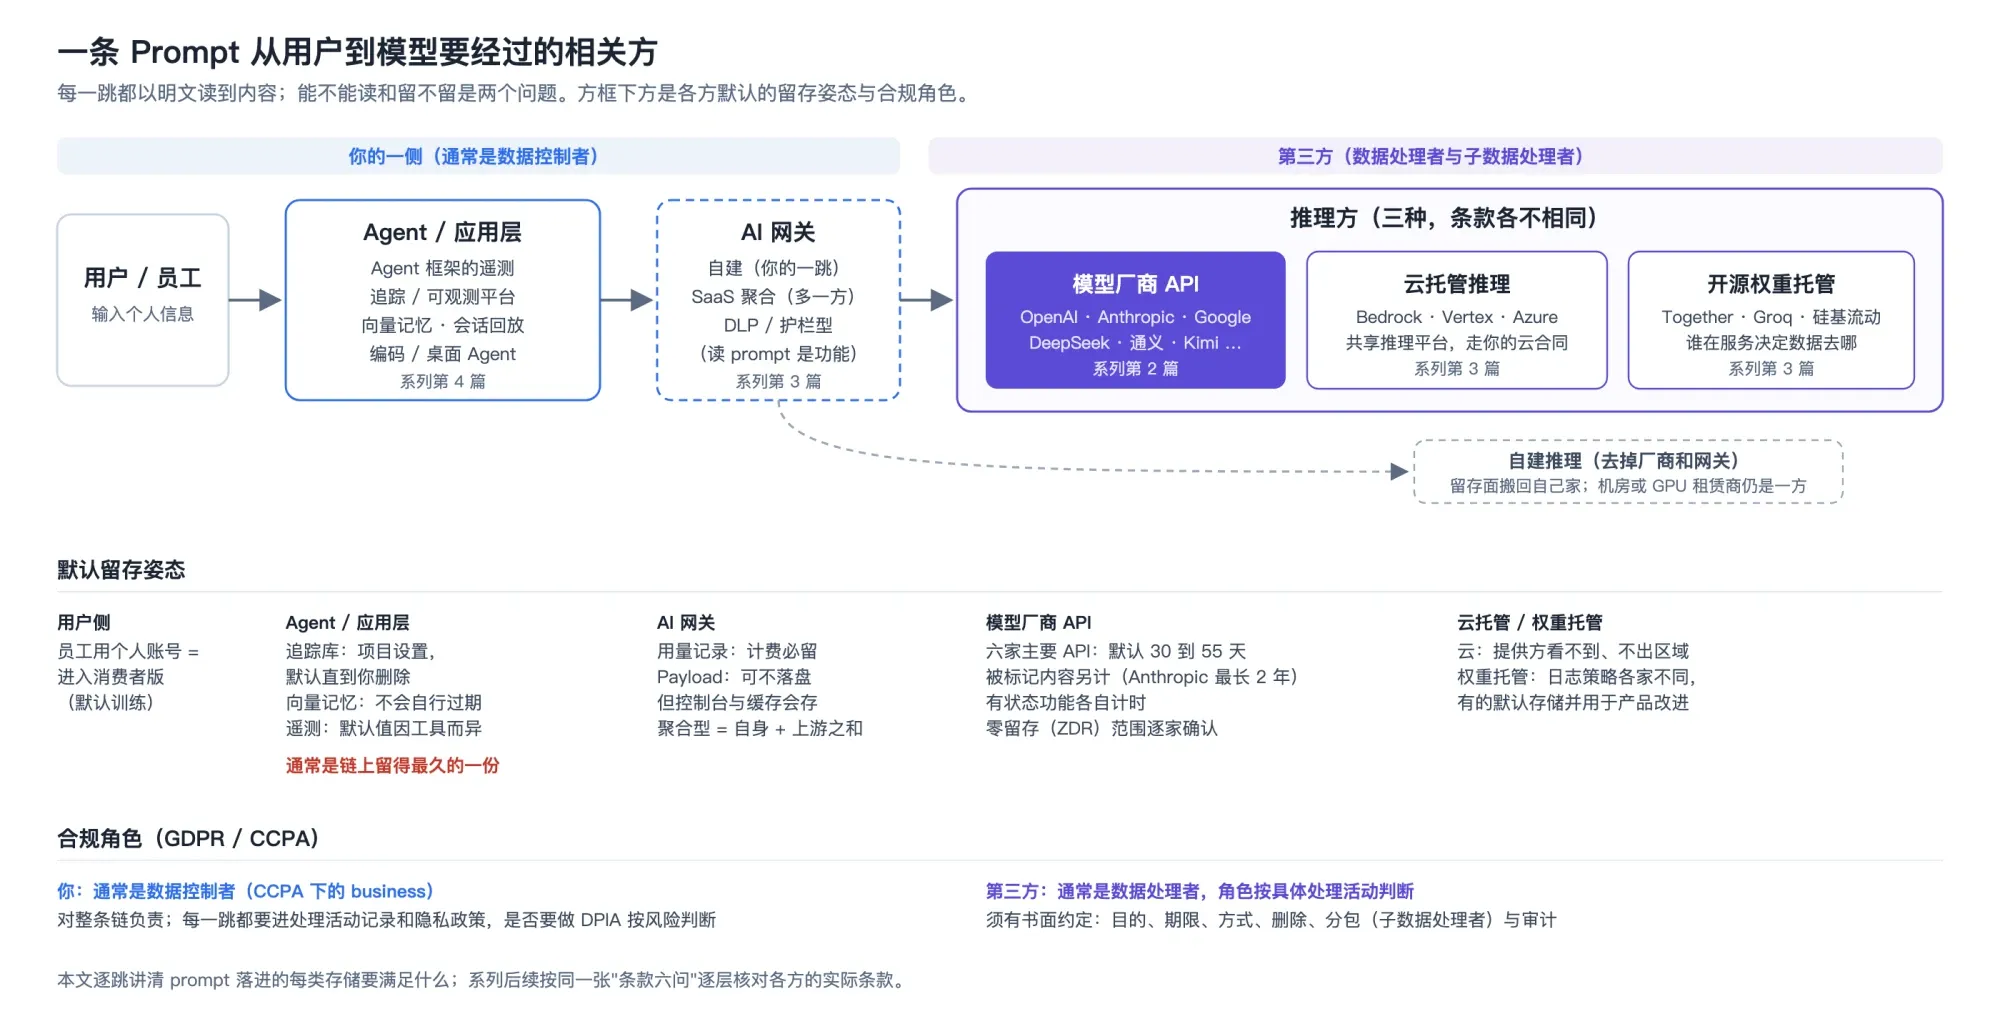
AI 数据链路合规地图:prompt 会落进的 10 类存储各留多久
一条 prompt 从 Agent、追踪平台、AI 网关到推理方,可能落进 10 类存储:六家主要海外模型厂商默认留 30 到 55 天,追踪库和向量记忆默认留到你删,零留存覆盖范围要逐家确认,选了欧盟区也可能出区。本文逐跳讲清每类存储的合规要点、合同条款怎么用技术手段验证,以及评估任何供应商的六个问题。
公开录音进入AI训练,何时构成“声纹”收集?
Google近日请求法院驳回记者和配音演员依据BIPA提起的AI声纹诉讼。本文结合双方在驳回阶段的争议及相关判例,分析公开录音进入模型训练后构成声纹收集所需的事实联系。

英国 DUAA 2025 改写自动化决策,ICO 更新 ADM 指南
英国 DUAA 2025 于2025年6月19日颁布,第80条以新的第22A–22D条替换 UK-GDPR 第22条,放宽一般数据的自动化决策、收紧敏感数据处理。ICO 于2026年3月31日更新 ADM 指南草案,明确“实质性人类参与”标准、合法路径与安全保障措施。