AI 网关隐私:prompt 可能被送到中国,还可能被拿去训练
 Kaamel Lab
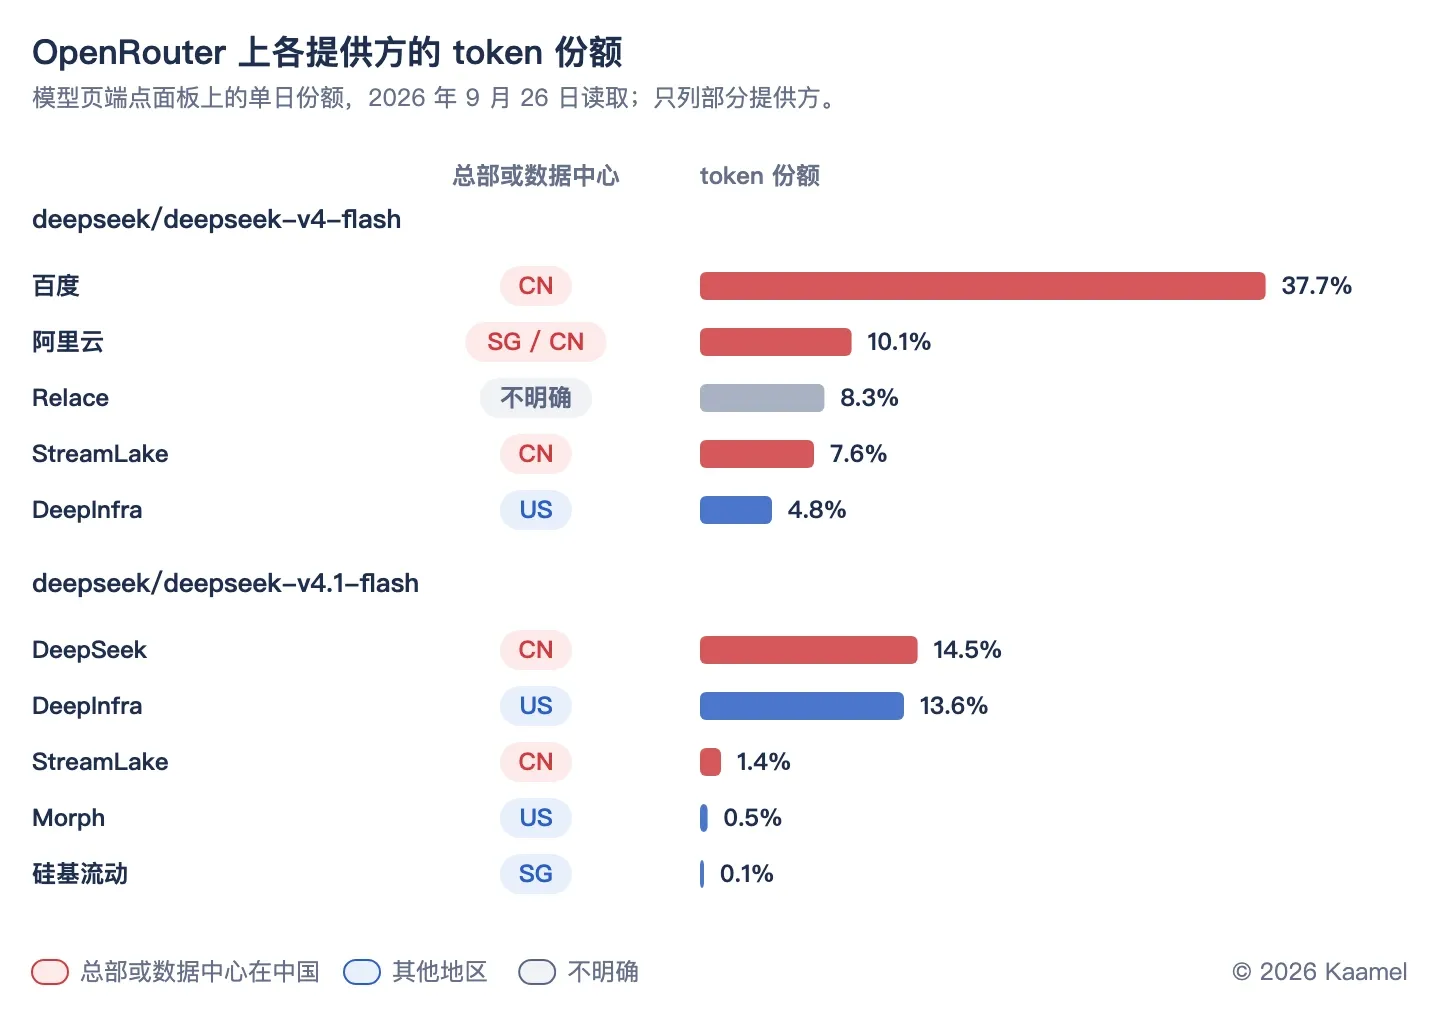
在 OpenRouter 上用默认的请求设置调用 deepseek/deepseek-v4.1-flash,只要你没关掉账号里”可能训练的提供方”那个开关,你的 prompt 就有可能直接落到 DeepSeek 自己在中国的 API 上。OpenRouter 给这个端点的面板上写着”Prompt training: Yes”和”Headquarters: CN”。按单日 token(模型计费用的文本单位)统计,它 2026 年 9 月 26 日承接了这个模型 14.5% 的流量,9 月 28 日是 13.2%。DeepSeek 的 API 条款适用中国大陆法律,没有承诺不拿 API 输入训练;它的《模型原理与训练方法说明》写着,训练用的问答对”是由我们的研究团队生产提供的,其中少部分数据的构造可能会基于用户的输入”。它说这类输入会去标识化,用户也可以选择退出,但没说 API 流量算不算在内,API 客户又该怎么退出。
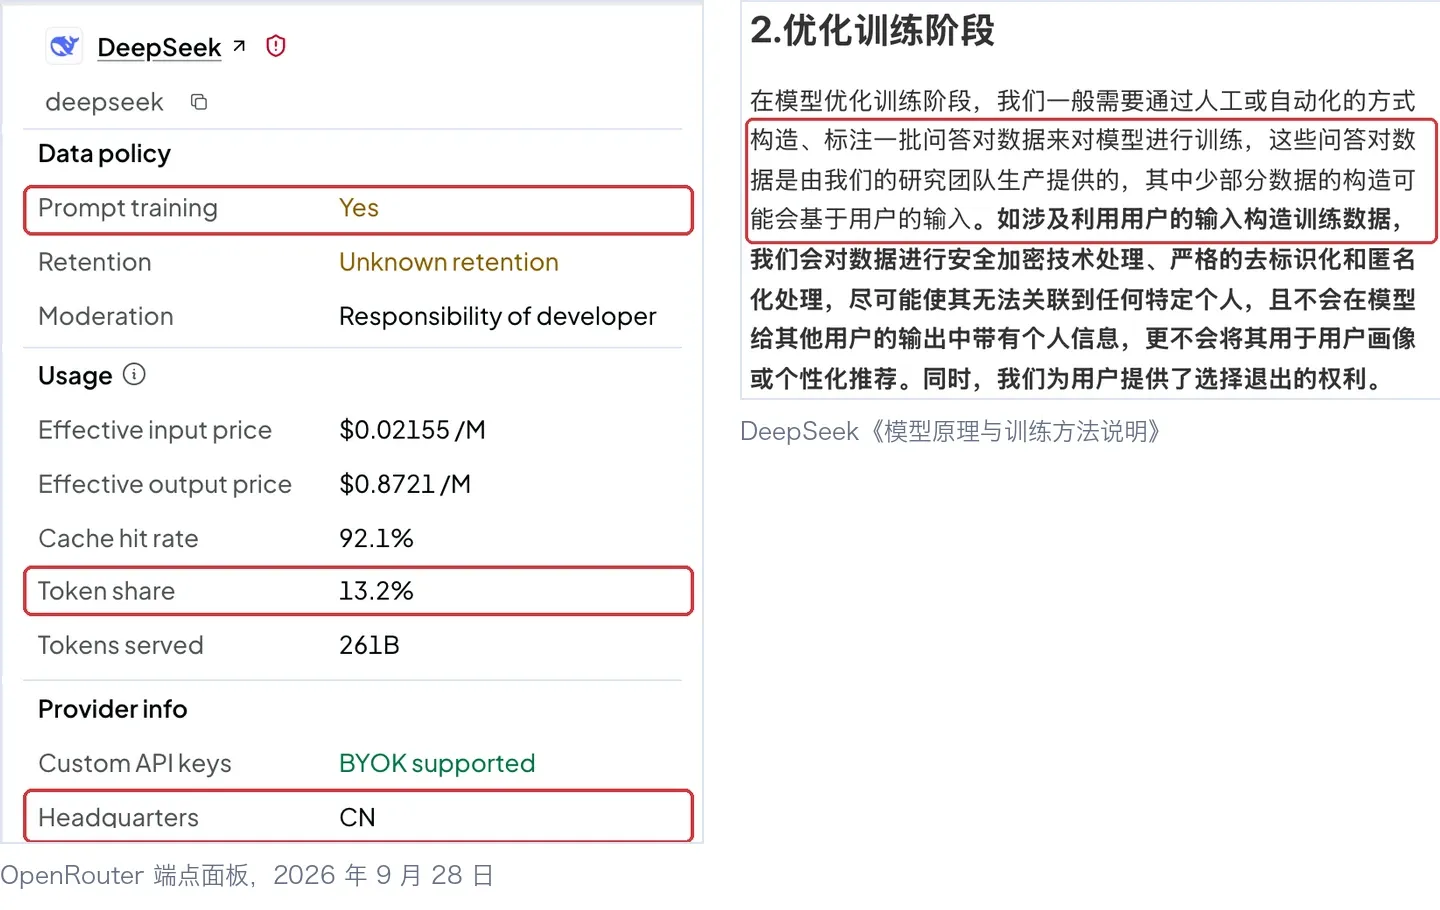
截图里的红框,标的是文中引用的内容。在网关上,模型开发方(比如 DeepSeek)发布模型,提供方(比如百度、DeepInfra)各自运行一份,每家提供方的这份部署就是一个端点,网关每次请求挑一个端点。
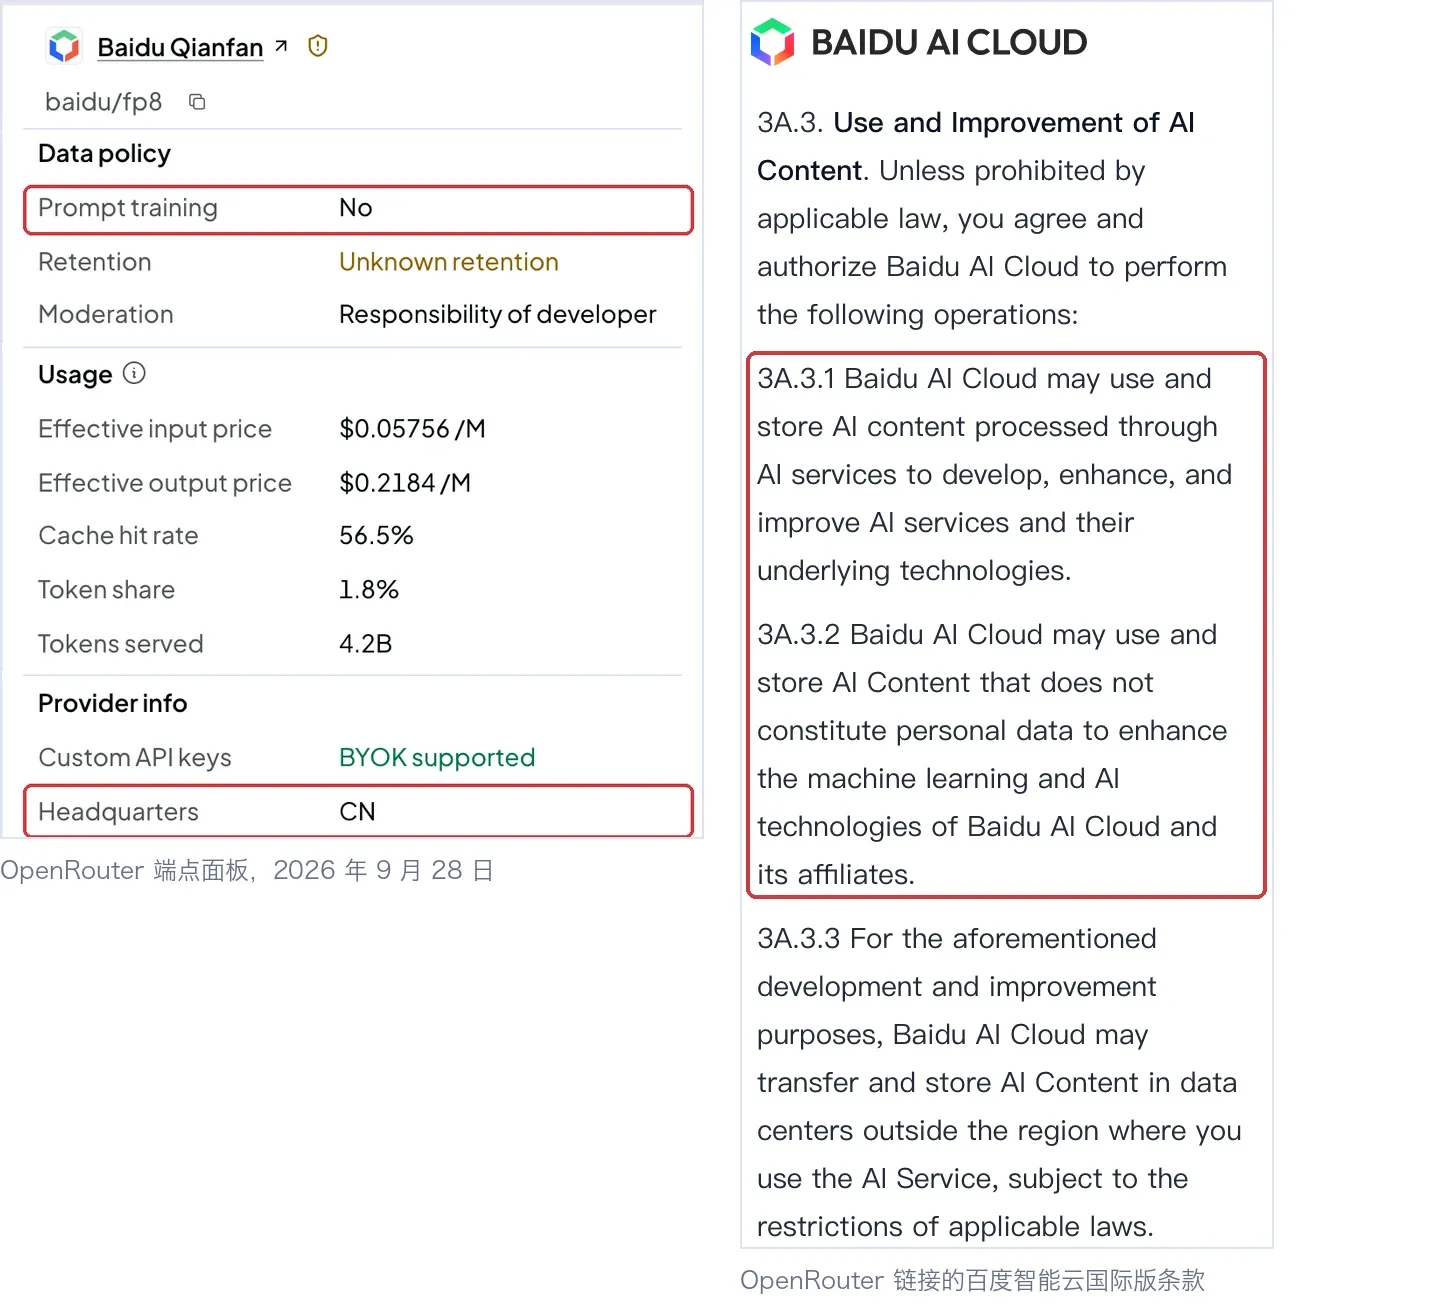
网关的标签也不能全信。同系列的 deepseek-v4-flash 最便宜的几家提供方里有百度,OpenRouter 给它标的是不拿 prompt 训练;可它在百度条目下链接的条款写着,百度可以拿你的内容”开发、增强和改进 AI 服务”,也没有给退出的办法。OpenRouter 如果和百度另签了更严格的协议,也没有公开。
训练比跨境传输更麻烦。日志可以删,数据一旦进了模型就拿不回来了。字节跳动旗下的 BytePlus 在自己的数据条款里也承认,你退出之前已经授权的数据”在技术上无法删除”。本文先分清哪些留存是必需的,再讲训练和其他你没同意过的副本。
核心要点
- AI 中间层的留存大多是正当的:计费、安全日志,还有你自己开的缓存和追踪。风险出在那些为厂商自身利益设的默认值上,其中训练是唯一收不回来的。
- OpenRouter 按价格路由,默认不按训练政策筛选。按单日统计,OpenRouter 标为总部在中国的百度和 StreamLake,9 月 26 日合计承接了
deepseek-v4-flash45% 的 token,9 月 28 日是 38%。 - 免费模型常常是拿数据换的。OpenRouter 自己说”大多数免费端点会拿收到的 prompt 训练,或者可能公开它们”;火山方舟和 BytePlus 每个模型每天最多送 500 万免费 token,换的是 prompt 和输出的永久授权。
- 能不能拿去训练,看的是合同,不是模型,也不是国别。走智谱国内站的条款,免费 GLM-4.7-Flash 的 prompt 可以用来改进服务,匿名化后还能训练;走 Z.ai 新加坡的条款就不行。
- 美国公司把大量美国敏感个人数据发给中国系提供方,可能构成美国司法部数据安全规则下的受限交易。这里的中国系,指依中国法律设立、主要营业地在中国,或被这类公司持股 50% 以上。
- 自己部署开源权重模型(权重公开、谁都能下载运行),模型开发方就碰不到你的数据,但要先查清平台默认的区域和日志设置。
本文是”AI 供应链的隐私合规”系列的第五篇,第四篇讲的是 AI Agent。这一篇看 AI 网关、模型托管方、免费模型、自部署平台和追踪工具,文档查阅时间为 2026 年 9 月 25 日至 28 日。
分析依据:本文依据厂商公开的文档、条款、隐私政策和源码,OpenRouter 的公开 API 和模型页,以及监管机构公布的文件。文中引用的英文原文均为我们的译文。这些数据流我们还没有抓包验证,之后会用技术手段实测。
AI 网关和托管方的哪些数据留存是必需的?
没有它服务就跑不起来的留存,是必需的;厂商为了自己的利益默认留下的,才值得追问。我们把厂商给出的留存目的分成了四类。
取值说明:Needed 表示服务离不开,比如计费;Chosen 表示客户自己开启的功能,比如缓存;Allowed 表示法律允许厂商保存的用途,比如滥用检测、法院要求的保全;Hidden 表示默认开着、服务用不上、又容易被忽略。最后一栏按 GDPR 判断:Processor 表示厂商只替你处理数据,Controller 表示厂商把数据用于自己的目的,在这部分处理上成了控制者,Depends 表示要看具体情况。
风险藏在隐性默认值里。 Together 写明”默认存储 prompt 和模型响应,用于产品改进”,服务条款却说内容只”在提供服务所必需的范围内”使用。Coze 把客户内容拿去”训练和改进我们的技术,比如机器学习模型和算法”,只要账号还在就一直留着。n8n Cloud 用 PostHog 做会话回放,21 天后删除,但 PostHog 不在它的子数据处理者清单上,这与 n8n 把它当作自己的数据处理相符。
同一条款,在美国过得了关,到欧盟未必。 厂商把客户数据拿来自用,欧洲监管机构会看作控制者的行为。欧洲数据保护委员会(EDPB)写明,处理者”不得为自己的目的处理数据”;英国信息专员办公室(ICO)也说,AI 开发者”为自己的目的”处理数据,就是”这部分处理的控制者”。《加州消费者隐私法》(CCPA)的实施细则反而允许服务商在一定限度内用客户数据改进自己的服务。
AI 网关怎么在你不知情时把 prompt 送到中国、送进训练?
它按价格挑端点,数据政策只拿来展示,不参与路由。OpenRouter 的文档写明,默认”在提供方之间负载均衡,优先考虑价格”。data_collection 参数默认是”allow”,意思是”允许那些不只是临时存放用户数据、还可能拿来训练的提供方”;文档还写明,“OpenRouter 的路由规则不随提供方的留存政策而变”。账号设置里另有两个开关,决定能不能路由到可能拿数据训练的提供方,付费模型、免费模型各一个,默认值没公开。另有 zdr: true,只路由到零留存清单上的提供方。
总部和数据中心按 OpenRouter 提供方 API 的标注;签约主体可能不同,见下文的端点表。份额取自各模型页的端点面板,算的是所有客户一天的流量,不区分各自的设置,每天都会变。图里只列了部分提供方,所以份额加起来不到 100%。
这件事容易被忽略,有两个原因。
标签和提供方自己的条款对不上。 OpenRouter 把百度列作 Baidu Qianfan,标的是”Does not train”。可它在百度条目下链接的,是百度智能云国际版的条款。条款把 AI 内容定义为”你提供的内容”,允许百度拿来”开发、增强和改进 AI 服务及其底层技术”,还可以用不属于个人数据的内容”增强百度智能云及其关联公司的机器学习和 AI 技术”。百度国际版的隐私政策还写明,客户的部分个人信息”存储在位于中国的服务器上”;条款没写 API 内容在哪里处理。
StreamLake 是快手的新加坡公司,OpenRouter 把它的总部标为中国,也标成不训练;它的条款却允许用你的输入”创建、测试、改进、训练”自己的模型,你可以发邮件撤回授权。Kimi 国际版条款写的是,除非另有书面约定,它”可以使用客户内容”;阶跃星辰国际版的条款让它拿到 prompt 的永久许可,“可用于任何目的”。OpenRouter 说它有时会和提供方另签更严格的协议,但这些协议都没公开,客户没法核实自己的流量到底适用哪套条款。
流量跟着价格走,份额几天之内就会大起大落。 9 月 26 日,百度在 deepseek-v4-flash 的 16 个端点里价格并列第三便宜,承接了当天 37.7% 的 token。到 9 月 28 日,百度和 StreamLake 都挂着约 40% 的折扣,百度不到 2%,StreamLake 却有约 36%。两家总部在中国的提供方合计先是 45%,后是 38%。OpenRouter 的隐私政策也写明,用户数据一旦发给允许训练的提供方,“OpenRouter 无法控制提供方那一侧的训练”。
别的网关也差不多。Vercel AI Gateway 默认路由时”不考虑提供方的训练数据政策”;Together 默认开启透传模型,也就是把”prompt 和响应直接转发给上游提供方”。
免费模型拿什么换?
往往就是你的 prompt。OpenRouter 的帮助中心写明,“大多数免费端点会拿收到的 prompt 训练,或者可能公开它们”;要用免费模型,得打开”Free endpoints that may train on request data”(允许可能拿请求数据训练的免费端点)这个开关。新账号默认开没开,它没说。按 OpenRouter 自己 2026 年 9 月 28 日的标记,比例没这么高:20 个免费端点里有 10 个会拿 prompt 训练,没有一个公开 prompt。这 10 个来自 NVIDIA、Thinking Machines、Poolside 和 Liquid,没有一家是中国公司;Thinking Machines 在免费层条款里拿到”永久”许可,可以用来”训练、微调、评估和改进”它的模型。
当天没有免费端点由总部在中国的提供方运行;中国团队开发的免费 Qwen 和 Ling,由标着不训练的美国提供方运行。
取值说明:条款允许提供方拿输入训练、改进或优化自己模型或服务的,“可用 prompt 做改进”一栏标 Yes。讯飞限定在去标识化或匿名化之后的数据;智谱只把模型训练限定在匿名化数据上。“国际版”一栏看同一家公司是否另设签约主体、单独提供这项服务:Not found 表示我们没找到,NA 表示这一行本身就是中国大陆以外的服务。“可退出”一栏里,Future only 表示退出只停止以后的采集,已经用过的数据仍在授权范围内;NA 表示本来就不拿 prompt。
有的免费方案把交换条件写在明处。 火山方舟的协作奖励计划每天为每个模型采集最多 500 万 token 的 prompt 和输出,第二天发放同等数量的免费额度。授权期限是永久,数据一旦用过,“对该部分协作奖励数据的使用将在技术上无法撤回”。截至 9 月 28 日,DeepSeek、Kimi、GLM 这些第三方模型也在计划里,本期合作期到 2026 年 9 月 30 日结束。BytePlus 在新加坡做同样的交换,拿的是”不可撤销的……永久”许可。这两个计划都要主动加入;火山方舟的默认免费额度走标准条款,条款排除了训练。OpenRouter 的隐身模型(stealth model,用代号上架、尚未公布身份的模型)也是免费的,条件是你把”用户内容”交给模型提供方,而且 OpenRouter 可以不告诉你提供方的”名称或来源”。
只在国内站提供的免费 API,条款大多允许拿 prompt 做改进。 智谱 bigmodel.cn 把 GLM-4.7-Flash 列为免费。条款允许智谱用你使用过程中产生的数据”定位、维护和优化我们的产品和服务”(另有约定的除外);不涉及个人信息的内容,智谱拿到永久、可再许可的使用权;它还可以”使用匿名数据进行机器学习或模型算法训练”。智谱的新加坡版 Z.ai 同样免费提供这个模型,却承诺”除非你明确同意”,不会拿 API 内容开发或改进服务。
讯飞星火 Lite 和美团 LongCat 都免费,条款都允许拿输入输出优化服务,也都没有像样的退出办法:讯飞”用于本协议下产品及服务的优化”,想拒绝,条款给的途径只有一个知识产权投诉邮箱;LongCat 拿的使用权用途还包括”模型服务优化、品牌推广与宣传”。LongCat 的英文法律页面打不开,中国大陆以外的用户签的就是中文合同。匿名化解决的是个人信息的问题,管不到 prompt 里的代码、合同和产品规划。
国内站也不都拿 prompt 训练。 硅基流动国内站的隐私政策写明,“不会将您的业务数据用于任何大模型的预训练、微调或其他商业用途”;快手国内的万擎平台也写明,未经书面同意,“不会存储或使用您的数据用来训练及优化模型”。
哪些中国系模型端点把数据留在中国或用于训练?
DeepSeek API,以及 Kimi、智谱、阿里云、火山方舟、腾讯的国内版,都在中国境内处理数据。有八个端点没有排除训练,其中五个是国际版。同一家公司往往国际版、国内版各有一套,签约主体和条款都不一样。
取值说明:只有提供方的 API 条款或隐私政策写明”未经你同意不用 API 数据训练”,“条款排除训练”一栏才标 Yes。Account life 表示账号在就一直留;As needed 表示没有固定期限;Flagged only 表示只留触发安全过滤的输入;Flagged 180d 表示这类输入留 180 天;Contract +30d 表示合同结束后 30 天内删除;Not stored 表示不留存 API 内容;Unclear 表示条款没写。MY / ID 是马来西亚和印度尼西亚;BVI 是英属维尔京群岛,据百度向美国证券交易委员会(SEC)提交的文件,百度智能云国际版的签约主体 Baidu Holdings Limited 就注册在那里。百度千帆国内版的协议没写处理地点。
中国系不等于在中国处理。 阿里云百炼国际版的推理跑在”中国大陆以外的全球节点”,并承诺”绝不会将您的数据用于模型训练”;Z.ai 在新加坡处理 API 数据,不过它的母公司智谱 2025 年 1 月起被列入美国商务部实体清单(一份出口管制名单)。对美国数据来说,这些新加坡公司,还有百度那家英属维尔京群岛公司,都属于中国集团,下文讲的司法部规则照样管得到。
国际版不一定更严。 百度和快手的国际版条款允许训练,它们的国内版反而排除了。Kimi 国际版由新加坡公司运营,除非另有书面约定,可以使用客户内容。MiniMax 国际版跑在美国,却可以把输入用于”提供、维护、开发和改进我们的服务”。
把 prompt 发给总部在中国的提供方,法律上意味着什么?
对美国公司,要看美国司法部的数据安全规则;对欧盟数据,要看 GDPR 的跨境传输规则,柏林的监管机构已经认定 DeepSeek 应用把用户数据传到中国违法。
美国数据安全规则。 美国司法部为落实第 14117 号行政令出台了数据安全规则。依中国(含香港)法律设立、或者主要营业地在中国的公司,在这套规则里叫”涵盖主体”(covered person);由这类公司持股 50% 以上的公司也算,新加坡子公司也不例外。API 属于”供应商协议”。规则把供应商协议定义为提供商品或服务(明确包括”云计算服务”)以换取”付款或其他对价”的安排,所以拿数据换来的免费额度多半也算。如果一份供应商协议让涵盖主体接触到大量美国敏感个人数据,它就是受限交易。受限交易要满足美国网络安全和基础设施安全局(CISA)的安全要求,这一条从 2025 年 4 月 8 日起适用;从 2025 年 10 月 6 日起,还要有书面合规计划和审计。对出海企业来说,美国客户做供应商审查时,可能拿这条规则来审你调用 AI 的方式。
“大量”有具体门槛:基因数据是 100 名以上美国人,特定个人标识符是 10 万名以上美国人,都按 12 个月累计。CISA 要求防止涵盖主体接触”可关联、可识别、未加密或可解密”的数据,模型 API 偏偏要读明文 prompt,很难做到。司法部至今没有针对 AI API 的指引,也没说经网关调用时网关的客户该怎么算,以上是我们的解读。另外,美国《2026 财年国防授权法》禁止国防部承包商在履行合同时使用 DeepSeek 模型;这项禁令看的是模型由谁开发,所以自己托管的看来也在其中。
GDPR 跨境传输。 中国没有拿到欧盟的充分性认定,往中国传数据要靠标准合同条款(SCC)这类保障措施,还要做跨境传输影响评估。如果处理者必须”以明文访问数据”,EDPB 说它”无法设想有什么有效的技术措施”能挡住公权力的过度访问。柏林数据保护专员 2025 年 6 月向苹果和谷歌举报 DeepSeek 应用,认定”中国当局拥有广泛的访问权限”。
中国法律。 中国的《国家情报法》和《数据安全法》要求组织支持、配合国家情报工作,也要配合执法机关调取数据。这些义务落在这家中国公司身上,不管它的客户在哪里。
自己部署模型,能掌控多少?
比任何共享 API 都多,但得先改掉默认值。把开源权重模型部署在自有基础设施或 GPU 云上,区域自己选,日志记什么由自己的代码决定,模型开发方也不会经手你的数据。
| 网关(OpenRouter) | 托管 API | 自己部署 | |
|---|---|---|---|
| 谁选提供方 | 网关 | 你 | 你 |
| 区域 | 默认全球 | 托管方定 | 你选(默认常是全球) |
| 用你的数据训练 | 看路由 | 看条款 | 模型开发方不会 |
| 记录正文 | 看情况 | 看情况 | 你的代码加平台日志 |
| 工作量 | 低 | 低 | 高 |
取值说明:正文指请求和响应的内容。Logs on、App logs、Logs in US 表示平台默认留存容器或应用日志(Modal 存在美国);Logs 30d、Logs 90d 是平台留存容器输出的时长。No access 表示操作员无法访问正文;Opt-in gate 表示厂商有员工访问的审批环节,但要你自己打开;Permission 表示默认要经你同意才能访问;Remote logs 表示厂商员工能查你的日志;Logged 表示员工访问会留记录,但没有审批环节;Terms only 表示访问限制只写在合同里。Multi 表示有多个区域可选,Via US 表示输入要经美国中转。“专用 GPU”一栏看能不能拿到不和其他客户共用的 GPU,Opt-in 表示可以另行购买。
默认值照样说了算:Fireworks 和 Baseten 默认全球调度;容器日志成了 prompt 的又一份副本,就算在你自己的 AWS 账号里,CloudWatch 默认也永久保留。厂商访问大多靠流程管,连 Baseten 的自托管方案都写明”部分平台数据会”离开你的环境。Bedrock 自定义模型导入是设计上的例外:AWS 说 Bedrock 采用零操作员访问模式,除自动化滥用检测外,服务操作员都无法访问模型的输入和输出。
网关和追踪工具的哪些默认值让数据留得太久?
日志和追踪数据是你自己选的功能,但默认的留存期往往比需要的长。
- 没有期限的网关日志。 Cloudflare AI Gateway”每个网关的日志默认开启”,2026 年 9 月 24 日前建过网关的账号,日志”直到你删除”才清掉。LiteLLM 只要没设
turn_off_message_logging,就会把 prompt 发给配置好的每一个日志回调;它的精确缓存也不按客户隔离,不同租户发来相同的 prompt,可能拿到同一份缓存答案。 - 比留存设置活得还久的追踪副本。 LangSmith 新建的评估器和自动化规则,默认把追踪数据的留存期从 14 天延到 180 天;加进数据集的追踪数据”永远不会删除”。Langfuse 写明”项目数据留存不会删除审计日志或数据集条目”。
上线前要核对什么?
如果今天只做一件事:用 OpenRouter 的 ignore 清单屏蔽数据不能去的提供方,并记下每个请求由哪家承接。下面九项,能覆盖前面提到的大部分风险:
- 在 OpenRouter 上设
data_collection: "deny"和zdr: true。零留存清单里仍有总部在中国的腾讯,以及中国集团旗下的新加坡公司,所以还要把数据不能去的提供方加进账号级的ignore清单。 - 到 OpenRouter 账号设置里,付费模型和免费模型各有一个允许路由到可能训练的提供方的开关,两个都要关掉(OpenRouter 没公开它们的默认值);每个请求由哪家承接,要记下来。
- 生产流量接入某家提供方之前,读它自己的条款,别只看网关的标签。
- 公司和客户的数据别发给免费端点、隐身模型和拿数据换额度的计划;这些只用来跑合成数据或公开数据。
- 调用中国系模型时锁定端点:美国托管方、Bedrock 或自己部署(国防部承包商连自己托管的 DeepSeek 模型也不能用);不涉及司法部规则的,也可以选条款排除了训练的国际版。
- 发送美国个人数据前,先确认提供方是不是司法部规则下的涵盖主体(在中国或香港设立、主要营业地在那里,或被这类公司持股 50% 以上),你的数据量有没有超过”大量”的门槛。
- 欧盟个人数据有可能流向总部在中国的端点时,要么屏蔽这条路由,要么备齐 SCC 和跨境传输影响评估。
- 在自部署平台上锁定区域,关掉组织级存储,查清容器日志存在哪、留多久。
- 关掉网关的正文日志或设好留存期,在缓存键里加上租户标识,给追踪平台设留存期。
常见问题
OpenRouter 会把我的 prompt 送到中国吗?
会有这种可能。OpenRouter 的默认设置不会排除总部在中国的提供方。按我们读取的单日数据,标着会拿 prompt 训练的 DeepSeek 自有端点承接了 deepseek-v4.1-flash 13% 到 15% 的 token,百度和 StreamLake 合计承接了 deepseek-v4-flash 38% 到 45% 的 token。用 ignore 屏蔽这些提供方,就能把它们排除在路由之外;只设 zdr: true 不够,因为 OpenRouter 的零留存清单里还有腾讯,以及月之暗面、MiniMax、智谱和字节跳动的新加坡公司。
免费 AI 模型会拿我的 prompt 训练吗?
很多会。按 OpenRouter 自己 2026 年 9 月 28 日的标记,20 个免费端点里有 10 个会拿 prompt 训练;NVIDIA、Thinking Machines、智谱国内站、讯飞和美团 LongCat 的免费方案,条款都允许提供方拿 prompt 改进自己的模型或服务。
主要来源:OpenRouter 提供方路由、提供方日志、免费模型的数据设置、隐身模型条款;百度智能云国际版服务条款、隐私政策;DeepSeek 开放平台服务条款、模型原理与训练方法说明;BytePlus 数据协作条款;智谱用户协议;美国司法部数据安全规则;EDPB 第 01/2020 号建议;柏林数据保护专员关于 DeepSeek;Baseten 自托管。图中其他取值依据各家截至 2026 年 9 月 25 日至 28 日的文档、条款和隐私政策。
“AI 供应链的隐私合规”系列
- AI 数据链路合规地图:prompt 会落进的 10 类存储各留多久
- 13 家大模型 API 隐私尽调:至少 3 家默认拿数据改进服务,4 家没有公开 DPA
- AI 编码 Agent 隐私:别信那个开关
- AI Agent 隐私:prompt 之外的九条数据通道
- AI 网关隐私:prompt 可能被送到中国,还可能被拿去训练(本文)
本文是从工程和合规角度对厂商条款的梳理,不构成法律意见。
相关阅读
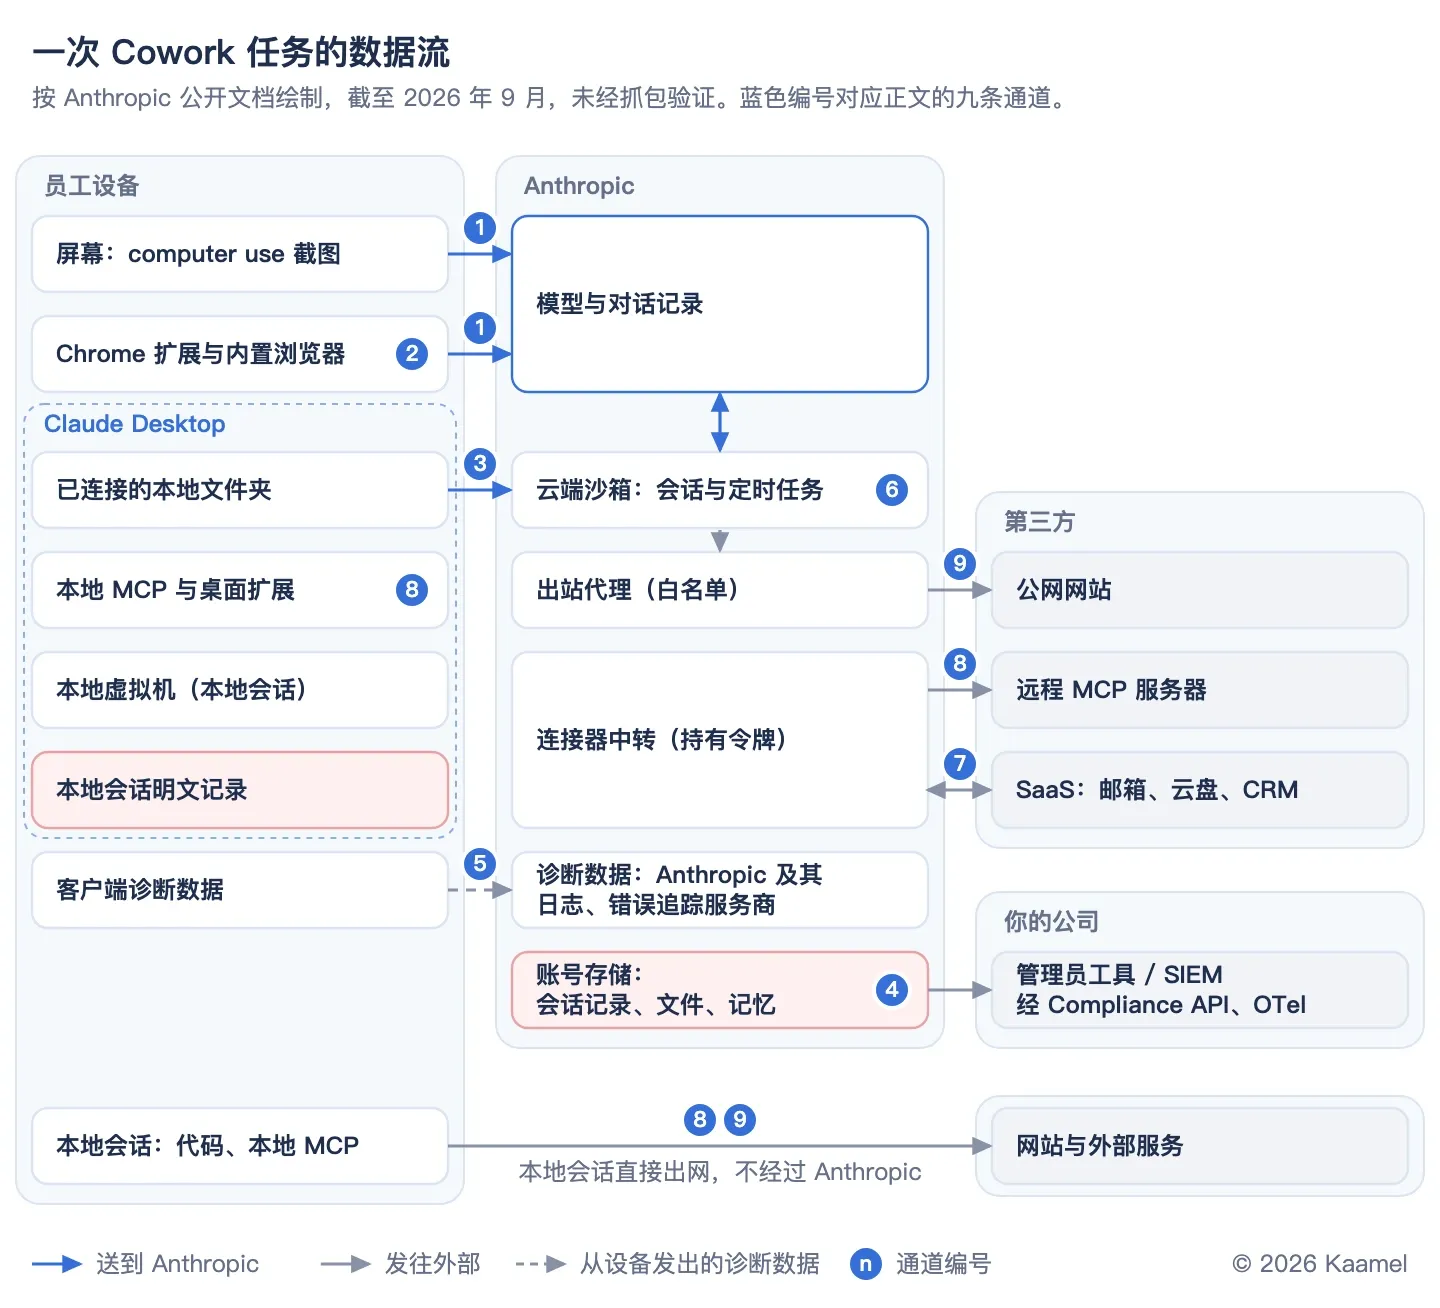
AI Agent 隐私:prompt 之外的九条数据通道
一次 Agent 任务在 prompt 之外还会打开九条数据通道:截图、登录会话、本地文件、记忆、MCP 调用各有去向和留存期。我们拆开一次 Claude Cowork 任务,再对比 23 款 Agent 的默认值。
AI 编码 Agent 隐私:别信那个开关
Grok Build 上传整个 Git 仓库,ZCode 上传工作区快照,Trae 关掉遥测仍上报,Claude Code 在 prompt 里藏标记。逐起对照隐私政策原文和实际行为,再看 15 款有海外运营的编码 Agent 默认会把什么发出去。
AI 数据链路合规地图:prompt 会落进的 10 类存储各留多久
一条 prompt 从 Agent、追踪平台、AI 网关到推理方,可能落进 10 类存储:六家主要海外模型厂商默认留 30 到 55 天,追踪库和向量记忆默认留到你删,零留存覆盖范围要逐家确认,选了欧盟区也可能出区。本文逐跳讲清每类存储的合规要点、合同条款怎么用技术手段验证,以及评估任何供应商的六个问题。